Дослідження екосистеми інструментування OpenTelemetry
OpenTelemetry складається з багатьох частин: API, SDK, протокол, семантичні домовленості, інструментування та інструменти на кшталт Колектора. API та протокол визначають, як створюється та надається телеметрія, а інструментування — це те, що фактично спостерігає за тим, що відбувається всередині застосунку, і перетворює це на телеметрію. Семантичні домовленості дають людям, які пишуть таке інструментування, спільний спосіб описати те, що вони спостерігають.
Привабливість цього підходу в тому, що цілком незалежні автори можуть інструментувати різні бібліотеки різними мовами й усе одно створювати телеметрію, яка відповідає тому самому контракту. HTTP-запит виглядає як HTTP-запит незалежно від того, яка бібліотека чи мова його створила. Користувачі можуть будувати запити, інформаційні панелі та інші інструменти на основі цього спільного розуміння. Щойно ми погодили домовленості, усе має збігатися.
Але поки що це не так, принаймні не зараз.
Домовленості розвиваються, а домени потребують років, щоб стабілізуватися. HTTP увійшов до специфікації у червні 2019 року, і його основні домовленості досягли стабільного стану аж у листопаді 2023 року. Домен бази даних стартував приблизно тоді ж і дійшов до цього лише у травні 2025 року.
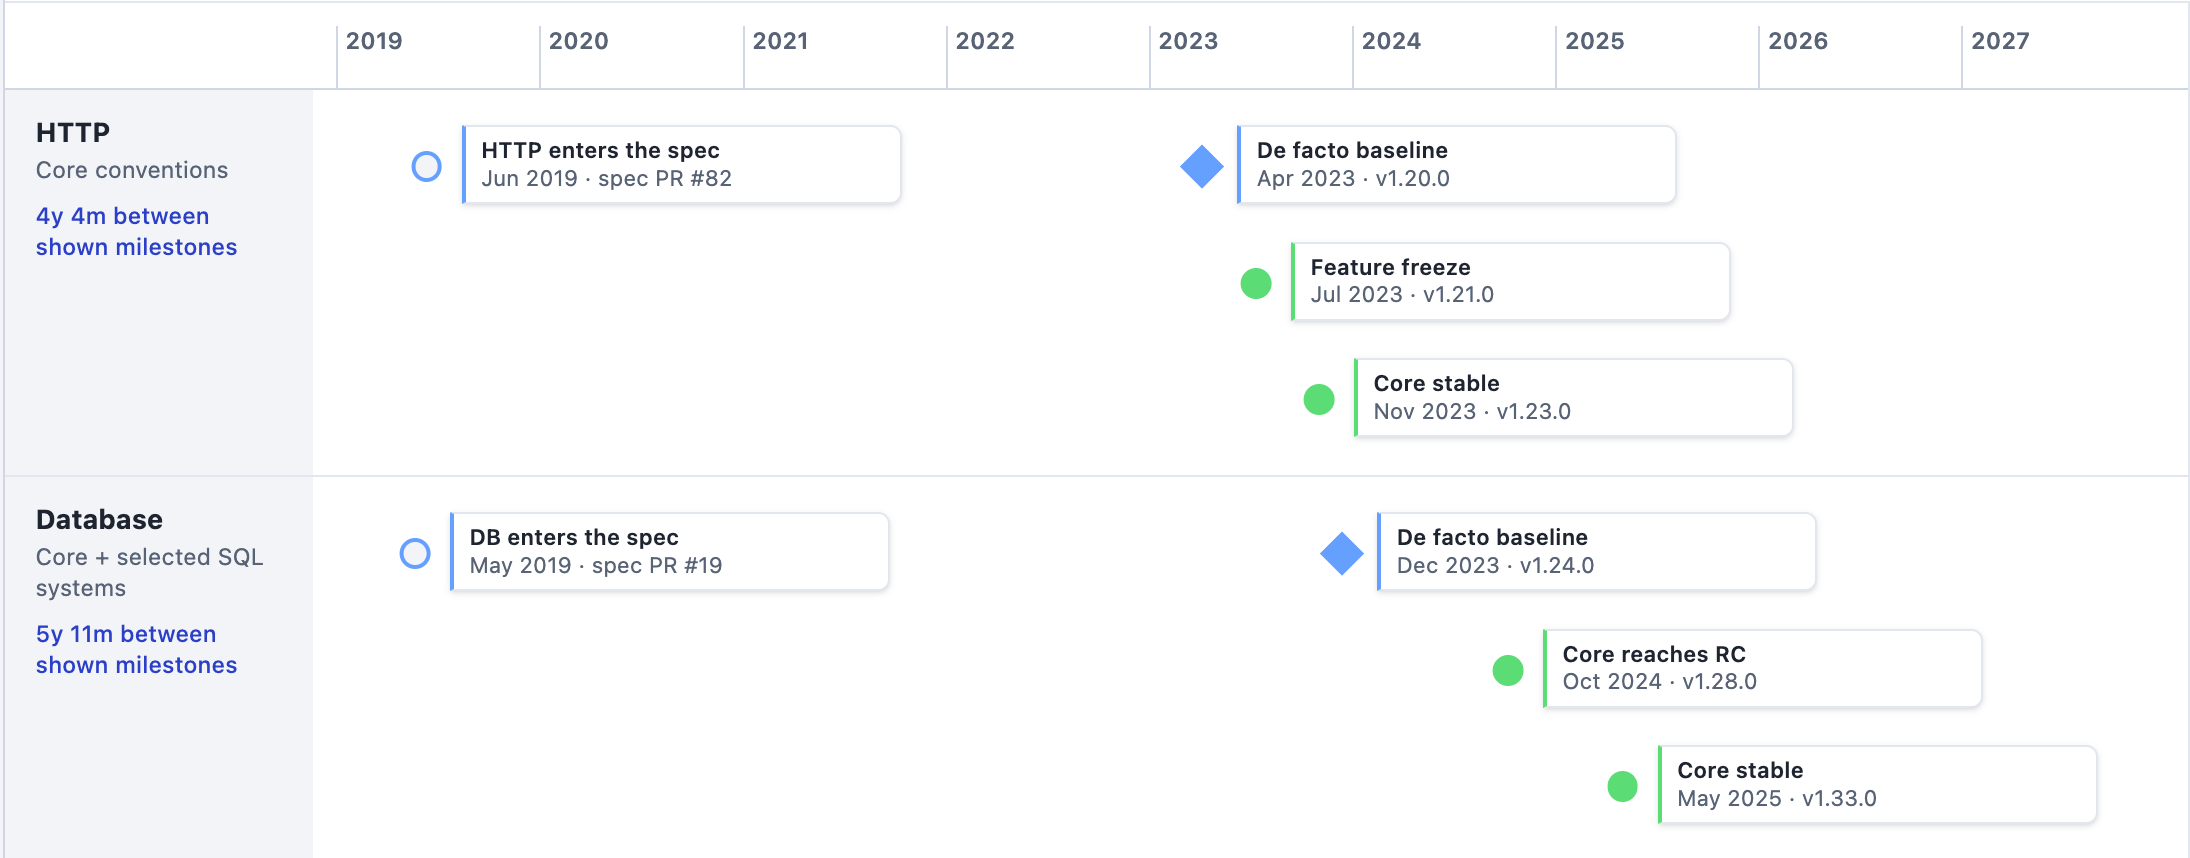
Хронологія семантичних домовленостей для HTTP і баз даних: від входження до специфікації до стабільного набору основних домовленостей.
Тоді бібліотекам інструментування по всій екосистемі доводиться наздоганяти, і через це стабільна домовленість стає радше відправною точкою, ніж фінішною лінією. Публікація домовленості не оновлює автоматично код, який її реалізує, а читання домовленості не скаже вам, які бібліотеки вже внесли зміни. Навіть перевірка інструментування може бути непростою: те, що воно випускає, може залежати від конфігурації та від того, що насправді робить застосунок.
Коли домовленість стабілізується, як швидко за нею прямують реалізації? Де нам усе ще бракує атрибута чи метрики? На ці запитання важко відповісти, не переглянувши інструментування та не перевіривши, що воно створює. А перш ніж робити це систематично, потрібно знати, які компоненти існують і що кожен із них має робити.
OpenTelemetry Ecosystem Explorer — це вебсайт, який каталогізує компоненти екосистеми OpenTelemetry та описує, що робить кожен із них. Уже сьогодні ви можете переглянути Java-агент і Колектор з детальною інформацією про компоненти та порівнянням випусків. Для Java-інструментування можна вибрати версію та побачити описану телеметрію разом з її параметрами конфігурації.
Ось що існує сьогодні. Те, до чого ми прямуємо, — це поєднання вимірювань із проєкту semantic-conventions-conformance з тією інформацією про компоненти, щоб показати, на якому рівні перебувають реалізації, і дати супровідникам і учасникам чітке розуміння, на чому вони можуть зосередити свої зусилля.
Що я маю очікувати від цього інструментування?
Перш ніж впроваджувати інструментування чи оновлювати його, потрібно знати, що воно створюватиме. Які відрізки та метрики воно описує? Які атрибути до них додаються? Які сигнали потребують конфігурації і що змінилося від версії, яку ви використовуєте?
Нещодавнє дослідження користувачів від Karimot Isiaka показало, як люди збирають ці відповіді з документації, репозиторіїв і приміток до випусків. Ecosystem Explorer обʼєднує цю інформацію в поданні, привʼязаному до конкретної версії. Для Java-інструментування можна переглянути описану телеметрію та параметри конфігурації, а потім порівняти випуски, щоб зрозуміти, що може змінити оновлення.
Що відбувається, коли ми дивимося на реалізації загалом?
Знати, що описує один компонент, — це лише початок. Щоб зрозуміти, де реалізації відстали, потрібно також залучити їх і подивитися на телеметрію, яку вони насправді випускають.
Саме це робить проєкт semantic-conventions-conformance. Він запускає невеликі тестові сценарії, збирає телеметрію та використовує функцію live-check від Weaver, щоб порівняти її із семантичними домовленостями й заявленими очікуваннями. Поточні результати публікуються у форматі JSON, який ми можемо агрегувати й аналізувати, щоб побачити, де реалізаціям бракує атрибутів, метрик чи інших очікуваних сигналів.
Тут потрібна певна обережність у тому, як ми це подаємо. Те, що атрибут не спостерігався в одному сценарії, не означає, що інструментування ніколи його не видає. Необовʼязковий атрибут може бути відсутнім, і це не свідчить про проблему, а експериментальна чи власна телеметрія все одно має залишатися видимою.
Java SIG уже використовує це для відстеження прогресу до випуску Java-агента 3.0. Домовленості для баз даних стабілізувалися, і ми досягли прогресу в RPC та обміні повідомленнями. Java-агент перейшов на стабільні HTTP-домовленості у 2.0, але аудит виявив прогалини, які ми виправили дорогою. Бачення цих прогалин допомагає SIG визначати пріоритети роботи та перевіряти її поступ.
Цей приклад стосується лише однієї мови. Для HTTP-клієнтів ми вже можемо дивитися ширше, бо кілька мов мають сценарії в проєкті conformance.
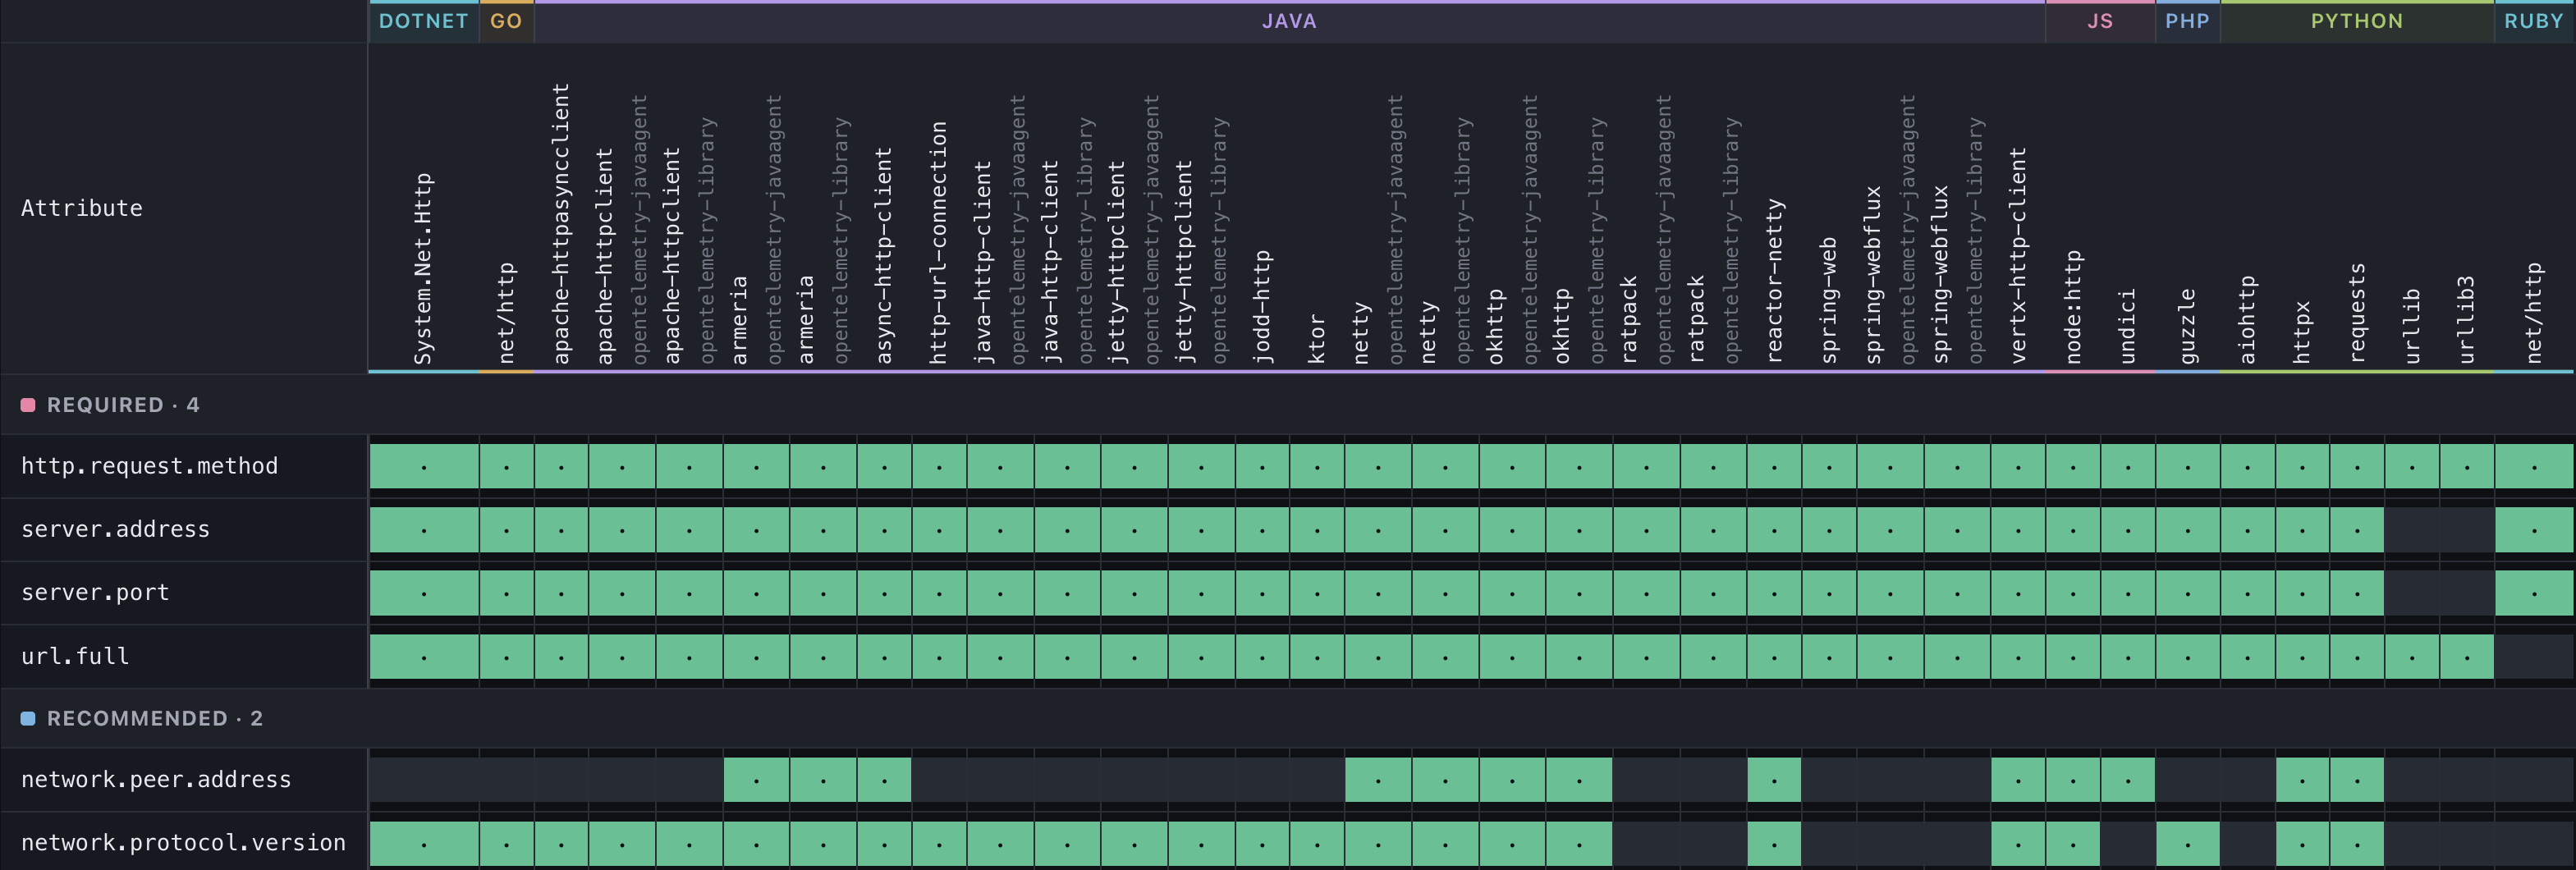
Вибрані атрибути HTTP-клієнтів, які спостерігалися під час тестових запусків conformance сімома мовами, згруповані за рівнем вимог.
У цьому зрізі чотири показані обовʼязкові атрибути спостерігалися майже в кожному перевіреному інструментуванні. Два показані рекомендовані атрибути спостерігалися менш послідовно. Порожня клітинка означає, що атрибут не спостерігався в цих запусках, а не те, що інструментування ніколи не може його випустити.
Коли більше проєктів долучатимуть структуровані метадані та повторювані вимірювання, нам хотілося б бачити таку саму картину для більшої кількості доменів: які прогалини постійно зʼявляються в різних бібліотеках? Де нам усе ще бракує тестів, щоб це знати?
Якщо вимірювання повторювати й привʼязувати до випусків, ми могли б також звітувати про те, як змінюється ця картина. SIG міг би побачити, які прогалини закрила його нещодавня робота. Керівництво проєкту могло б визначити напрями, де кільком SIG потрібна допомога з тією самою проблемою. Учасники могли б знайти роботу, яка підвищила б узгодженість у всьому домені інструментування.
Такі дані дали б нам змогу побачити екосистему загалом: що працює в усьому OpenTelemetry, де відбувається поступ і де допомога дала б найбільший ефект. Для того, хто будує інформаційну панель чи інтеграцію з постачальником, це могло б допомогти відповісти, чи можна покладатися на атрибут, чи потрібен запасний варіант, чи можна долучитися з виправленням.
Запропонований план розвитку OTel після отримання статусу дипломованого проєкту закликає до кращих інструментів інструментування, нижчих витрат на супровід і ширшого використання інструментів семантичних домовленостей різними мовами. Ми вважаємо, що унаочнення цих прогалин — один зі способів, якими Ecosystem Explorer міг би зробити внесок у ці цілі.
Сьогодні ці результати живуть у проєкті conformance як звіти із зафіксованих запусків, і поєднати їх із компонентами та випусками Ecosystem Explorer нам ще належить. Нам хотілося б, щоб користувачі могли подивитися на компонент і побачити, як змінювалося його покриття та як він порівнюється з іншими подібними компонентами.
Звідки береться вся ця інформація?
Вебсайт може показати лише те, що ми знаємо. Збирання цих знань і підтримання їх в актуальному стані в міру зміни коду забирає більшість роботи.
У Java перехід від базової підтримки метаданих до наповненого каталогу інструментування зайняв понад рік. Ця робота створила структуровану інформацію про інструментування, яку проєкт Java може використовувати у власній документації та каталогах, а Ecosystem Explorer її споживає й повторно використовує.
Ми вважаємо, що ці зусилля варті того, бо інформація корисна самому проєкту. Частину її можна згенерувати з коду, частина потребує, щоб супровідники описали задум і конфігурацію, а частина — перевірок під час виконання, щоб зʼясувати, що відбувається насправді. Разом ці джерела дають нам значно краще розуміння інструментування, ніж будь-яке з них окремо.
Саме тому ми хотіли б, щоб більше проєктів впровадили OpenTelemetry Weaver. Weaver дає проєктам змогу визначати схеми телеметрії в реєстрах семантичних домовленостей і використовувати ці визначення для генерації документації чи коду та для перевірки випущеної телеметрії. Навіть якщо проєкт починає лише з документації, він уже зробив свої визначення телеметрії структурованими та придатними для повторного використання. Генерація коду може спиратися на ту саму відправну точку, коли це буде корисно проєкту.
Для нас цінність у тому, щоб мати спільну основу для телеметричної частини цієї інформації. Визначення, що стоять за документацією проєкту, також можуть живити валідацію та давати таким споживачам, як Ecosystem Explorer, щось структуроване для роботи. Супровідники отримують користь у власному робочому процесі, а ми — чіткішу відправну точку для розуміння сигналів, які описують їхні компоненти.
Усе це залишає й інші запитання без відповіді. Які версії бібліотек підтримує компонент? Яка конфігурація вмикає сигнал? Що насправді спостерігав конкретний тест? Реєстр телеметрії — це лише частина цієї картини, поряд із метаданими компонентів і свідченнями часу виконання.
Інші екосистеми матимуть інші відправні точки. Ми можемо працювати з їхніми наявними форматами та інструментами; впровадження Weaver — це те, що ми заохочуємо, але воно не обовʼязково є передумовою для участі. Корисне місце для початку — це компонент, запитання, які люди про нього мають, та інформація, яка вже є в проєкту і може допомогти на них відповісти.
А що щодо проєктів поза OpenTelemetry?
Ті самі запитання стосуються бібліотек і проєктів, які супроводжують поза організацією OpenTelemetry. Якщо бібліотека називає себе сумісною з OpenTelemetry чи нативною для неї, що користувач може очікувати від цього? Як супровідники можуть це продемонструвати та підтримувати цю інформацію в актуальному стані?
Для супровідників, які думають про майбутнє включення до Ecosystem Explorer, це корисна підготовка. Визначте телеметрію, яку ваш проєкт планує надавати, опишіть компоненти та конфігурацію, що її створюють, і зробіть ці описи доступними разом із вашими випусками. Реєстр Weaver дає визначенням телеметрії придатне для повторного використання місце. Поєднання їх із метаданими компонентів і повторюваними перевірками дало б нам більше, на що спертися, коли ми беремо проєкт до Ecosystem Explorer, а вашим користувачам — корисну інформацію вже тепер.
Заморожування реєстру екосистеми нещодавно привернуло увагу до цієї проблеми. Надійшло більше заявок на включення, ніж супровідники мали часу й інструментів, щоб їх перевірити, а самого лише внесення проєкту до списку було недостатньо, щоб розповісти користувачам, що насправді робить його інтеграція.
У довгостроковій перспективі нам хотілося б, щоб проєкти могли підтверджувати конкретні твердження за допомогою повторюваних перевірок. Які сигнали вони випускають? Яких домовленостей дотримуються? Чи задовольняє телеметрія з їхніх тестових сценаріїв застосовні вимоги? Щоб хтось інший міг відтворити перевірку, звіт має містити:
- випуск, який тестується
- застосовані параметри конфігурації та те, що вони роблять
- сценарії, які було запущено
- версію семантичних домовленостей, з якою звірялися
Проєкти могли б запускати це в межах розробки та публікувати оновлені свідчення разом зі своїми випусками.
Запропонований проєкт OpenTelemetry Support Self-Assessment and Maintainer Guidance описує споріднену мету: інструменти, які супровідники можуть запускати самостійно, з посібниками для різних типів проєктів. Ця пропозиція залишає результати в супровідників проєктів, і якщо вони вирішать ними поділитися, ми могли б дослідити, як зробити ці свідчення доступними для пошуку в Ecosystem Explorer поряд з інформацією про компоненти.
Ще багато роботи й питань, які потрібно зʼясувати щодо залучення сторонніх проєктів і критеріїв прийняття. Обговорення реєстру називає Ecosystem Explorer його майбутнім наступником, але ми ще не готові взяти це на себе. Перевірки семантичних домовленостей дають нам гарну відправну точку, але неодмінно виникне потреба і в інших твердженнях про сумісність, які потребуватимуть власних перевірок.
Допоможіть нам це опрацювати
У нас є опублікований каталог інструментування Java-агента та напрями роботи, що тривають для інших мов і компонентів. Те, що нам усе ще потрібно опрацювати, — це як зробити цю інформацію придатною для повторного використання в усій екосистемі. Ми хотіли б почути від інших SIG, які думають над тим самим запитанням: які свідчення справді були б корисними їхнім користувачам?
Якщо ви супроводжуєте інструментування, почніть з одного компонента. Що вам уже говорять його вихідний код, конфігурація, документація та тести? Що можна згенерувати, а що потребувало б перевірки під час виконання? Принесіть цей приклад до проєкту Ecosystem Explorer, щоб ми могли опрацювати, як зробити інформацію придатною для повторного використання. Проєкт conformance також є місцем, де можна допомогти з вимірюванням випущеної телеметрії.
Якщо ви вже визначаєте свою телеметрію за допомогою Weaver, у вас є корисна відправна точка. Поділіться своїм реєстром і прикладом компонента в issue у проєкті Ecosystem Explorer, а також запитаннями, на які ви хотіли б, щоб Ecosystem Explorer допоміг відповісти. Приклади з різних екосистем допоможуть нам зʼясувати, як має виглядати інтеграція.