Кореляція трейсів і логів без програмування за допомогою OBI
Вас викликають за тривогою. Трейс показує, що запит зазнав помилки в одному з ваших сервісів, і ви знаєте, що відповідь у логах — але які саме рядки логів належать тому запиту? Якщо сервіс ніколи не впроваджував структуроване логування з контекстом трасування, чесна відповідь така: ви шукаєте за міткою часу й сподіваєтеся.
OpenTelemetry eBPF Instrumentation (OBI) тепер може додавати цей відсутній контекст трасування до логів, які ваші сервіси вже пишуть. Ваші застосунки не змінюються: без SDK, без налаштування бібліотеки логування, без повторної збірки чи повторного розгортання застосунку.
Одразу про межі застосування: це працює для логів, записаних у stdout або stderr — потоки, які перехоплює середовище виконання вашого контейнера, — і рядок анотується, коли OBI має активний контекст трасування для запиту, який обслуговується в момент запису. Усе, що ви розгортаєте, — це зміна конфігурації OBI та фільтр з одного рядка у вашому конвеєрі логів.
Під капотом OBI вже знає, через eBPF, який запит обслуговує кожен потік у момент, коли він пише рядок логу; у цьому й полягає вся хитрість. Поля кореляції додаються до того, як конвеєр логування контейнера отримує рядок. Далі в цій статті розповідається про те, що змінюється на практиці, що функція вимагає від вашого середовища та як її увімкнути.
Що змінюється під час інциденту
Ваш застосунок пише таке:
{ "level": "INFO", "message": "payment authorized", "amount": 42 }
Лог контейнера виглядає так:
{
  "level": "INFO",
  "message": "payment authorized",
  "amount": 42,
  "trace_id": "4bf92f3577b34da6a3ce929d0e0e4736",
  "span_id": "00f067aa0ba902b7"
}
Це ті самі ідентифікатори, які OBI зазначає для відрізків того запиту, тож кореляція працює в обидва напрямки: вставте trace_id із невдалого трейсу в пошук логів і отримайте саме ті рядки логів для цього запиту, або скопіюйте trace_id із підозрілого рядка логу у свій бекенд трейсів і потрапте на трейс, до якого він належить.
Це працює для логів у форматі JSON, NDJSON і простого тексту — до вільних рядків додається анотація key=value:
payment authorized trace_id=4bf92f3577b34da6a3ce929d0e0e4736 span_id=00f067aa0ba902b7
Якщо ваш логер уже виводить одне з налаштованих полів, OBI зберігає його і додає лише те, чого бракує.
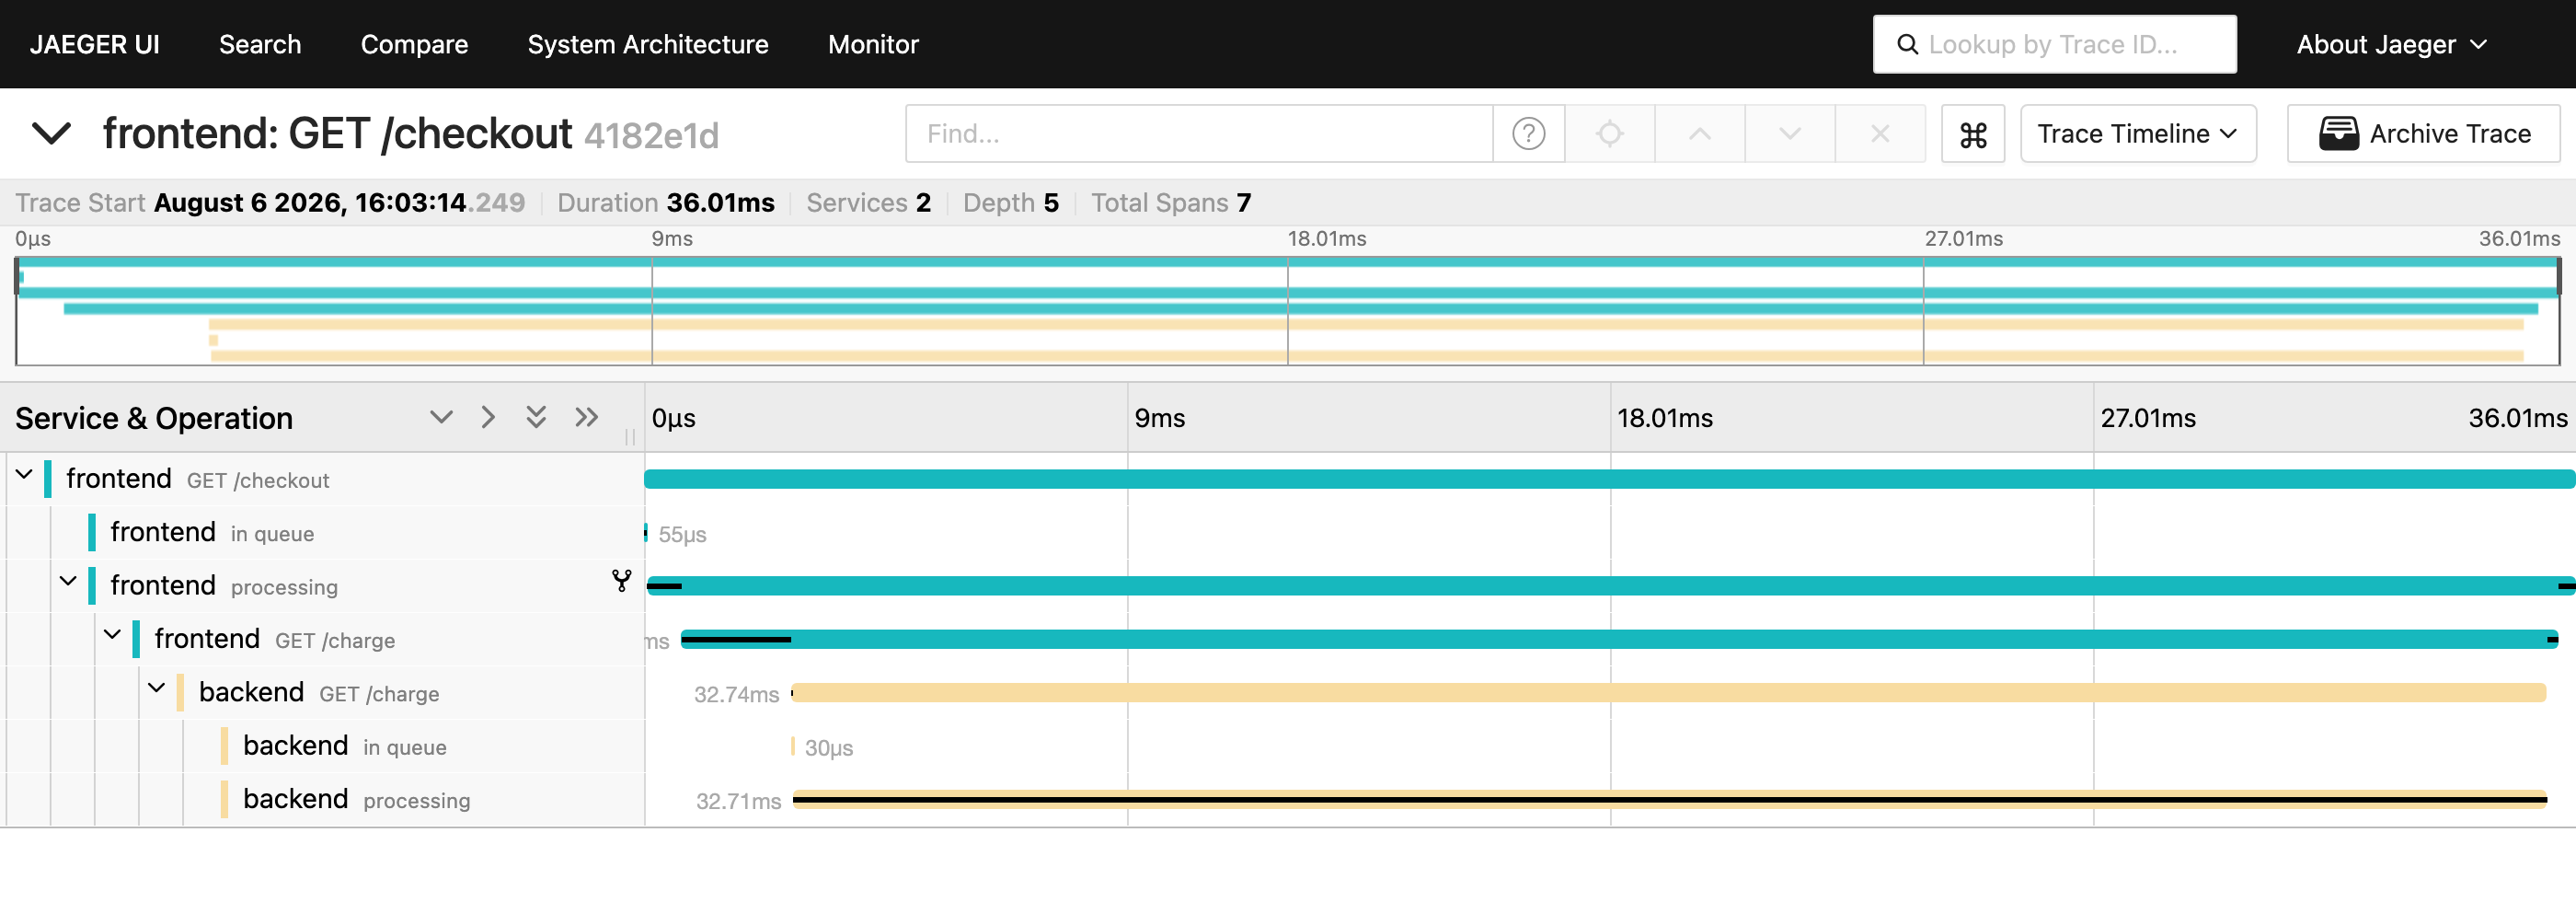
Ось як це виглядає наскрізно на невеликій демонстрації: Go-застосунок frontend без інструменталізації, який викликає Go-застосунок без інструменталізації backend, кожен логує один рядок JSON на запит, плюс OBI та Jaeger — загалом чотири контейнери. У коді застосунку немає жодного OpenTelemetry SDK.
Один запит до frontend створює один розподілений трейс у Jaeger — OBI також поширює контекст трасування між двома сервісами, тож відрізки frontend і backend обʼєднуються під одним трейсом:
Обидва сервіси записували звичайний JSON без полів трасування; OBI вставив відповідний контекст — той самий trace_id в обох сервісах, кожен зі своїм span_id:
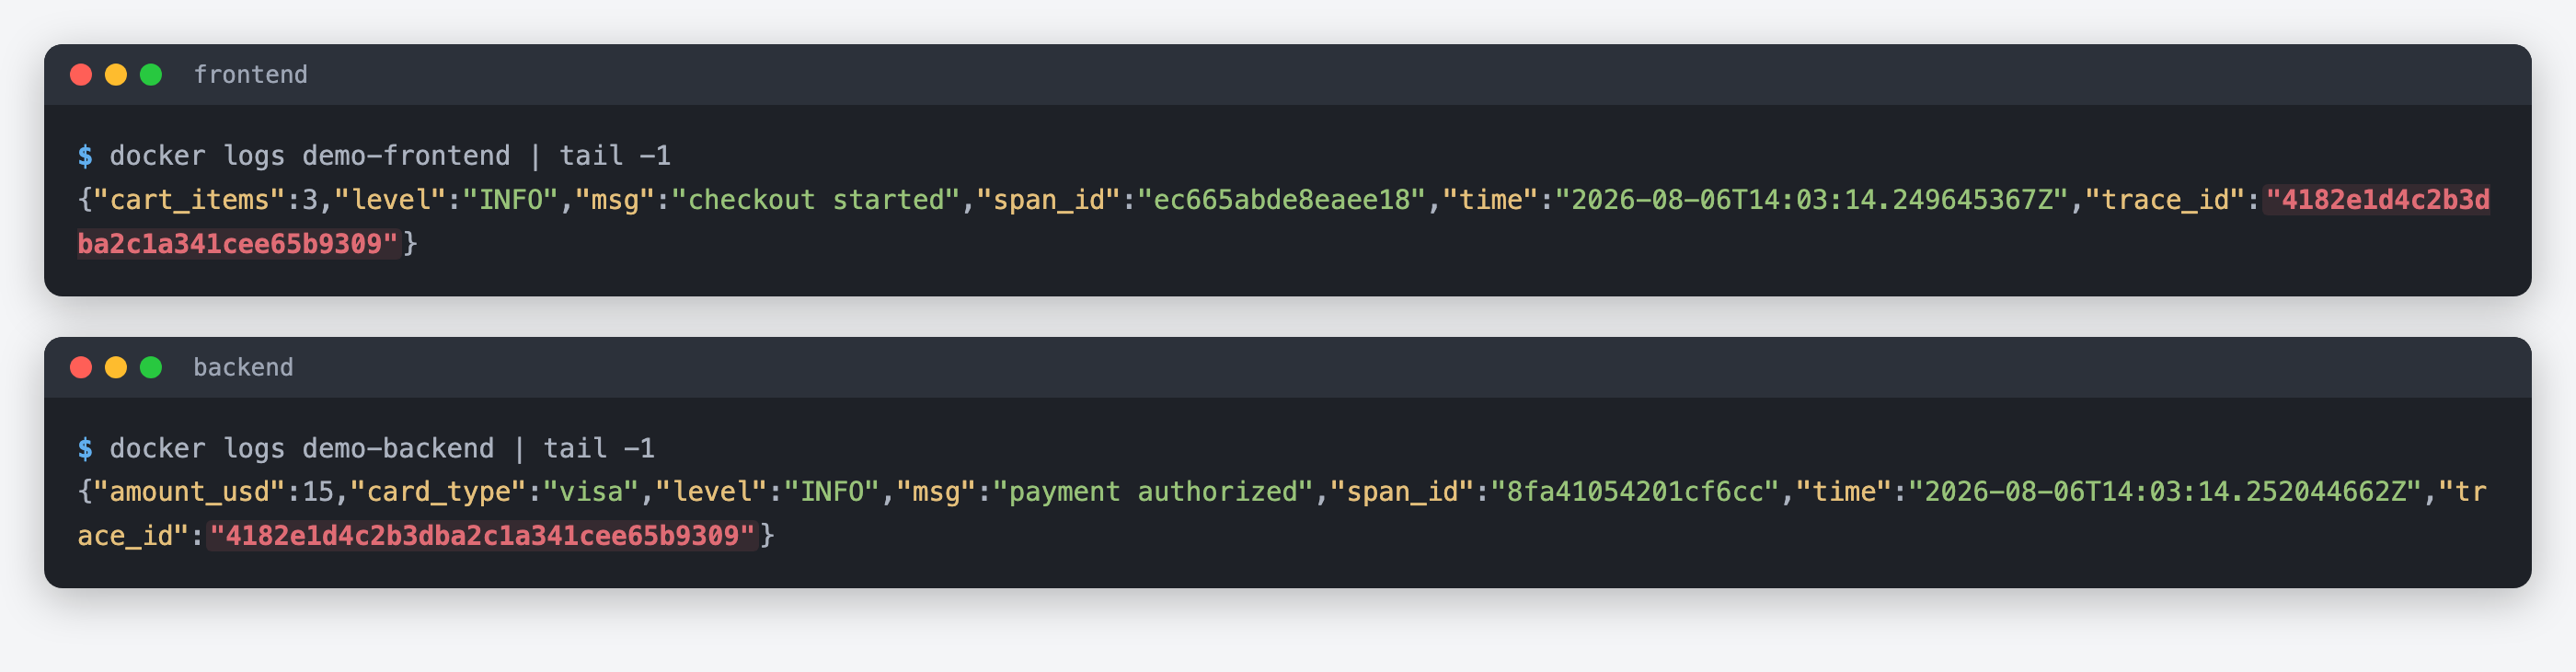
Пошук у Jaeger за trace_id з будь-якого з цих рядків логів приводить саме до трейсу, показаного вище.
Чи підходить це для вашого середовища?
Перевірте це перед тим, як планувати розгортання:
- Місце призначення логів. Збагачення охоплює логи, записані в stdout або stderr і перехоплені середовищем виконання контейнера. Логи, записані безпосередньо у файли або надіслані мережею дозатором, що працює в межах процесу, не охоплюються.
- Активний контекст трасування. Рядок збагачується лише тоді, коли він записується, поки OBI трасує запит у цьому сервісі — HTTP- чи gRPC-запит, клієнтський виклик або операцію з базою даних, що триває. Повідомлення про запуск і логи фонових завдань проходять без змін.
- Ядро та привілеї. Засобу збагачення логів OBI потрібен
CAP_SYS_ADMINі ядро, яке не перебуває в режимі блокування безпеки. Для збагачення звичайного шляхуwrite()потрібне ядро Linux 6.0 або новіше; на старіших ядрах збагачуються лише записи на основіwritev(), тож покриття залежить від того, як пише логер вашого середовища виконання. - Синхронне логування. Звʼязок між рядком логу та запитом ґрунтується на тому, що запис відбувається з потоку, який обслуговує запит. Логери Go, Java та Ruby роблять це стандартно. У Node.js stdout асинхронний, коли його підтримує pipe — стандартно в контейнерах — тож за зворотного тиску на запис окремі рядки можуть зникати або нести застарілий контекст. Python потребує
PYTHONUNBUFFERED=1; .NET потребує синхронного записувача консолі. Віртуальні потоки Java поки що не збагачуються; робочі навантаження на платформних потоках це не зачіпає. - Сервіси, інструментовані за допомогою SDK OTel. Збагачення працює й там і є корисним, коли SDK експортує трейси, але не логи: OBI вставляє лише
trace_id, бо згенеровані OBI ідентифікатори відрізків не збігалися б з ідентифікаторами SDK — а хибне посилання на відрізок гірше за його відсутність. Ви все одно можете знайти транзакцію в логах за ідентифікатором трейсу.
Як увімкнути
Засіб збагачення потрібно вмикати явно. У конфігурації версії 2 увімкніть його в extensions.obi.correlation.log_trace_annotation. Його список match приймає ті самі умови збігу, що й правила capture, і визначає, які захоплені робочі навантаження анотуються. Він має вибрати щонайменше одне робоче навантаження, а робоче навантаження поза вашим вибором capture ніколи не анотується:
extensions:
  obi:
    version: '2.0'
    capture:
      policy:
        default_action: exclude
      rules:
        - action: include
          match:
            process:
              exe_path_glob:
                - /frontend
                - /backend
    correlation:
      log_trace_annotation:
        enabled: true
        match:
          - process:
              exe_path_glob:
                - /frontend
                - /backend
        plain_text:
          enabled: true
          placement: suffix
          multiline: first_line
Блок plain_text керує тим, де анотація key=value розміщується в не-JSON логах і які рядки багаторядкового запису її отримують. Вставлені назви полів стандартно дорівнюють trace_id та span_id і налаштовуються через field_names, тож вивід відповідає тому, що вже очікує ваш конвеєр логів.
У конфігурації версії 1 той самий вибір міститься під ebpf.log_enricher.services — деталі дивіться в документації про кореляцію трейсів і логів.
Потрібна одна зміна конвеєра: для кожного збагаченого рядка оригінальний незбагачений рядок замінюється в логах контейнера на порожній рядок-заповнювач (NUL-байти), а збагачений рядок додається на його місце. Додайте у свій передавач логів фільтр, який відкидає порожні рядки-заповнювачі, — одне правило, що збігається із записами, які складаються лише з NUL.
Перш ніж вмикати це у виробничому середовищі
Поведінка, яку слід врахувати у плані розгортання:
- Великі записи розділяються. Один виклик
write()абоwritev(), більший за 8 KiB, не збагачується цілком: захоплений префікс видається повторно з контекстом трасування, тоді як решта потрапляє до потоку логів окремо, без збагачення — один логічний запис може стати двома. Якщо ваші сервіси регулярно виводять дуже довгі рядки логів, виміряйте перед увімкненням. - Розгортайте поступово. Почніть з одного сервісу з низьким ризиком у
matchі перевірте у своєму бекенді логів дві речі: порожні рядки-заповнювачі відкидаються вашим фільтром, а рядки логів зʼявляються один раз — не дублюються й не розділяються. Потім додайте більше сервісів уmatch. Сервіси, які ви залишили позаmatch, усе одно трасуються; незмінними залишаються лише їхні логи. Відкочування — це вилучення сервісу зmatchабо встановленняenabled: false, щоб вимкнути анотацію для всіх сервісів; застосунок залишається незмінним в обох випадках.
Спробуйте
Кореляція трейсів і логів постачається в OBI. Націльте її на один сервіс, додайте фільтр рядків-заповнювачів у свій передавач логів — і ваші наявні логи, без повторної збірки чи повторного розгортання застосунку, почнуть нести ідентифікатори трейсів, які були потрібні вам під час останнього інциденту.
- Запустіть демонстрацію з цієї статті самостійно: приклад docker compose
- Документація OBI
- Репозиторій OBI
- Цікаво, як це працює під капотом? Внутрішня будова eBPF описана в документації для розробників
- Запитання чи відгуки: канал #otel-ebpf-instrumentation у CNCF Slack